前言
原本要寫一份客戶說明,AI 幾秒鐘就吐出完整稿件。你以為快收工了,接著卻花時間找出多寫的承諾、核對數字、改掉不適合客戶的語氣,再把段落搬回公司格式。初稿很快,交付時間卻不一定縮短。
判斷 AI 是否提升生產力,要比較「達到同一個交付標準」的總投入。 生成速度、字數與功能數量,都不是完整答案。這篇不排行工具,提供一個可從日常工作開始的紀錄方法:先把工作拆成準備、生成、查核與修改,再決定下一次怎麼分工。
⏱️ 先看整份工作:四段時間一起算
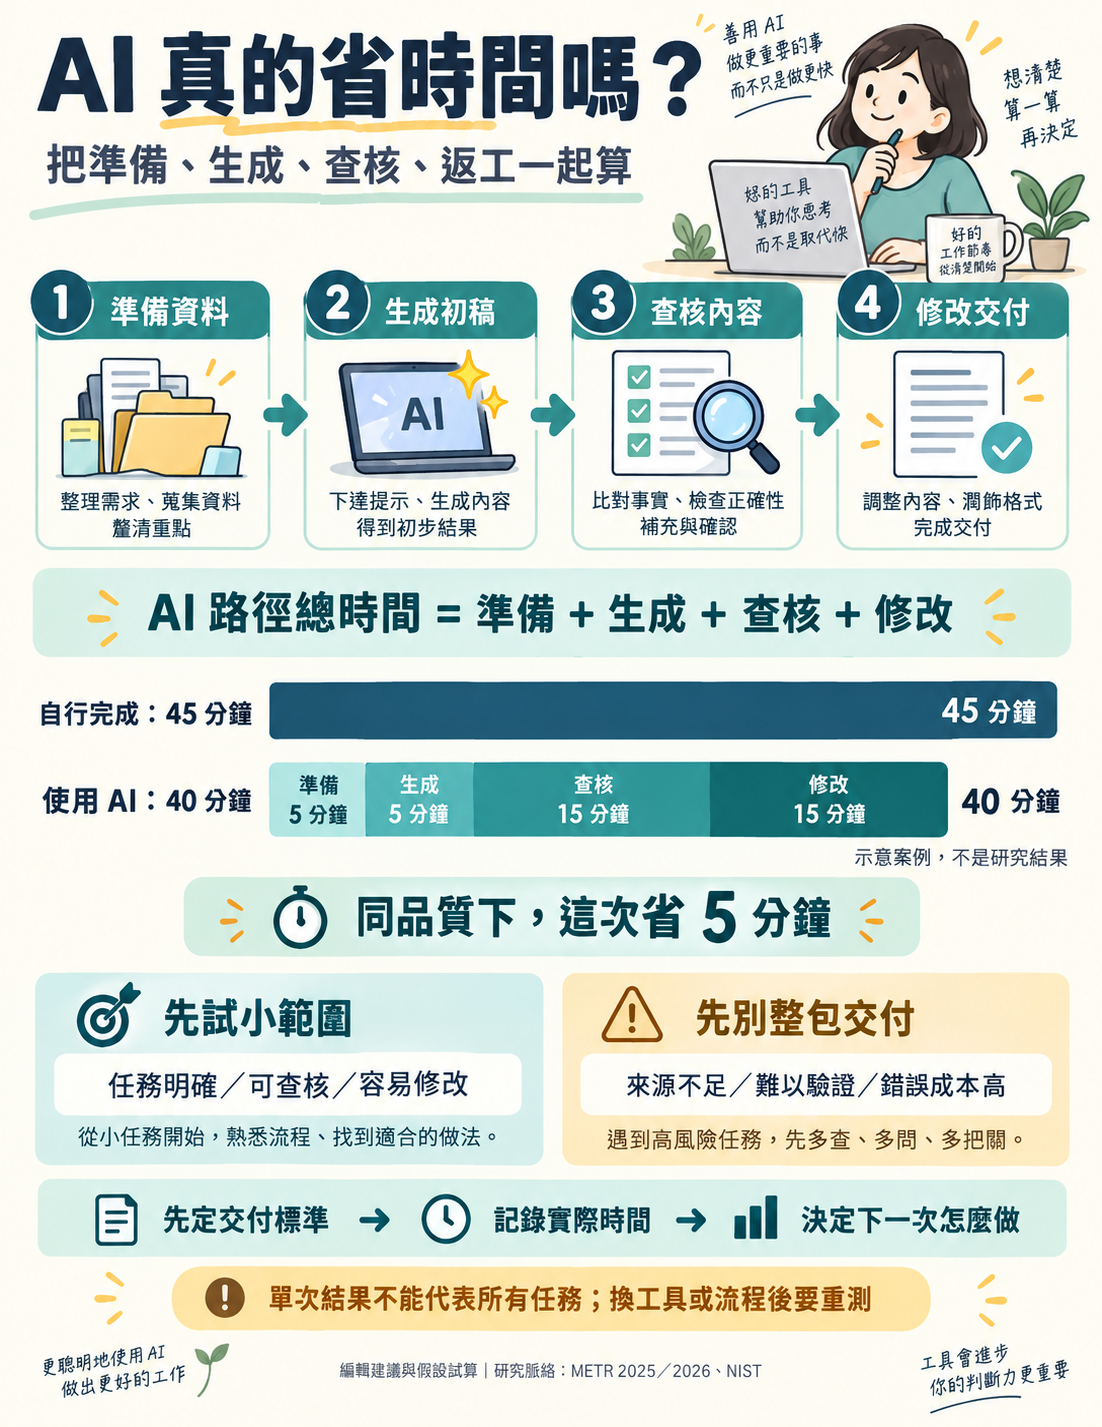
先把「完成」寫清楚。以對外說明為例,可以是指定格式、必要資訊齊全、數字能追溯、沒有未授權承諾,而且負責人已確認可寄送。若不用 AI 的版本只要求草稿,使用 AI 的版本卻要求正式交付,兩邊的時間就不能直接比較。
| 時間段 | 記哪些投入 | 容易漏掉什麼 |
|---|---|---|
| 準備 | 找資料、去識別化、寫任務與限制 | 把內部資料轉成 AI 看得懂的格式 |
| 生成 | 送出任務、等待、補充說明 | 等待時能否實際做別件事 |
| 查核 | 對照來源、檢查算式與內容要求 | 確認引用真的存在,而非只看語句順暢 |
| 修改 | 改錯、重排、驗收與交付 | 被退回後再修改的時間 |
下面是假設試算:不用 AI,完成同一份說明需要 45 分鐘;使用 AI,準備 5 分鐘、生成 5 分鐘、查核 15 分鐘、修改 15 分鐘,合計 40 分鐘。在這次且同品質的條件下,省的是 5 分鐘,不能因為初稿只花 5 分鐘,就聲稱整份工作快了九倍。
如果你等 AI 的同時完成其他工作,另外記「經過多久」與「自己實際投入多久」。不用把等待全部當成投入,也不要把同時處理兩件事的同一段時間各算一次,否則前後比較會失真。這份計時表是個人工作診斷,不是標準研究設計。
🔬 研究可以提供線索,別直接借用一個百分比
METR 在 2025 年公布的實驗,研究熟悉既有開源專案的開發者,使用當時 AI 工具處理真實任務。在那個條件下,AI 組的完成時間反而較長;研究者也明確提醒,結果不能推廣成「AI 對所有工程師或其他職業都無用」。它提醒我們,主觀覺得更快和實際完成時間可能不同。(依 METR 2025 原始研究說明)
後續也要一起看。METR 於 2026 年 2 月 24 日 更新研究,表示新資料有一些加速訊號,但參與者與任務的選擇偏差,以及同時使用多個 AI 代理時的計時困難,使結果不足以可靠估計當時的整體效益。因此,不能只把舊研究的減速結果當成所有新工具的現況,也不能把更新當成普遍加速的保證。(依 METR 2026 研究更新)
讀研究時,先問:是哪個年份的工具?做哪一種工作?受試者原本熟不熟?什麼算完成?時間和品質如何量測?研究答案與自己的工作有多接近,再決定拿來做哪一部分的參考。
本篇的四段計時法是編輯建議,不是照搬該研究的方法,也不把它包裝成能證明因果的實驗。你需要的是看懂自己卡在哪個環節,再試一個可觀察的調整。
🧪 小範圍試一次:從工作分段,而不是全部交出去
先選重複出現、容易說明完成條件,而且你能查核的任務。像把已確認的重點轉成固定格式、將一段自己熟悉的文字整理成兩種口吻,或為既有說明產生待審閱的常見問題,都比一開始就交出整個專案容易比較。
開始前用幾行寫下:
任務:把已確認的產品重點整理成客戶說明草稿
完成條件:必要重點不遺漏、不新增承諾、符合指定格式
可以提供:公司允許使用且已去識別化的資料
AI 負責:段落排列與語句草稿
我負責:逐項核對事實、調整用語、確認後交付
紀錄:準備/生成/查核/修改,以及是否需要再返工
這個示例沒有指定任何產品,也不代表公司允許把全部資料交給外部工具。先依工作場所的資料規則處理;如果限制使你不能提供必要內容,可以改成請 AI 建議空白格式,再自行填寫。
比較時盡量挑工作範圍相近的紀錄。不要把自己第一次做陌生任務的時間,和已做過許多次、又有 AI 協助的任務相減,然後把差額全部算成 AI 的貢獻。任務難度、熟悉程度、工具版本與交付要求都可能改變結果。
完成後只改一個明確環節。例如查核最久,就先限制 AI 只用提供的資料,並要求把待確認處另列;仍然要自己核對,不能把「只用提供資料」視為不會出錯的保證。若準備最久,則看能否在公司允許的範圍內保留可重用的空白欄位與說明格式。
🧨 常見誤區:越忙著用 AI,越難看出成果
問題: 內容很流暢,就不需要再確認。
真相: NIST 的生成式 AI 風險文件將虛構或錯誤內容列為應注意的問題;語氣肯定並不保證事實正確。
建議: 先列必要資訊與來源,查核事實、算式及未授權承諾;把確定和待確認的內容分開。
問題: 修一次就應該知道 AI 值不值得用。
真相: 單次任務可能特別容易、特別難,也包含首次學習的時間。
建議: 留下相似任務的紀錄,另記工具學習時間;換流程後重新觀察,不拿一個案例代表所有工作。
問題: 字數、回覆數或產出檔案變多,就是生產力提高。
真相: 多一份尚未查核的稿件,也可能增加待辦;有沒有被採用、能不能完成交付才是另一層問題。
建議: 記錄實際交付與返工情形,若只有初稿完成,就寫初稿,不直接宣稱效益已驗證。
| 目前狀況 | 可以先做的行動 | 下一次看什麼 |
|---|---|---|
| 任務清楚,也容易核對 | 先讓 AI 處理一個可修改的段落 | 是否達標、總投入是否改善 |
| 查核時間比原本撰寫還長 | 縮小範圍,補上可靠來源與限制 | 錯誤種類是否減少 |
| AI 經常漏掉內部規則 | 先整理可提供的規格與範例 | 必要規則是否仍被漏掉 |
| 不知道內容是否正確 | 先取得能判斷的資料或協助 | 有沒有足夠條件完成驗收 |
| 常被退回後重做 | 把退回原因納入交付條件 | 相同問題是否再次發生 |
若結果沒有節省時間,仍可能得到不同價值,例如比較容易開始、減少重複打字,或有更多可選的草稿。可以如實記錄這些感受,和時間結果分開;再決定自己願意為哪一種價值付出成本。
💡 結論懶人包
- 先定完成條件,再比較達到同一品質的整份工作投入。
- 準備、生成、查核與修改都要記,返工也不能漏掉。
- 研究有工具、年份和任務條件;舊結果與後續更新一起看。
- 先試一個能查核的小任務,找出最耗時的環節,只調整一件事。
- 初稿變多不等於效益已驗證;真正交付、品質與自身負擔都要分開觀察。
🔗 延伸閱讀
AI 回答很快,為什麼工作還是做不完?
產生回答只是其中一段。整理輸入、等待、查核、修改和交付也占用時間;需要把同等品質的一整份工作完成時間一起比較。
研究說 AI 讓工程師變慢,就代表我不該用嗎?
不能這樣推論。研究有特定工具、時期、受試者與任務條件。METR 的 2025 實驗不能直接套用所有職業,其 2026 更新也指出選擇偏差與計時問題。先測你自己的可比較任務。
第一次使用沒省時間,還值得練習嗎?
可以將學習工具的時間另作紀錄,再看熟悉後相似任務的結果。是否繼續投入,還要考慮交付品質、體力負擔、成本與你的工作目標。
📚 參考資料
資料查核日期:2026-10-13。本文不使用舊對話中未能核實的企業研究數字與名人引語。
- METR〈Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity〉:2025 原始研究與限制
- METR〈We are Changing our Developer Productivity Experiment Design〉:2026 後續更新
- NIST〈Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile〉:生成式 AI 風險文件 NIST AI 600-1